

 Télécharger l'article

Introduction
La crise sanitaire engendrée par le Covid-19 a donné lieu, au printemps 2020 et dans les mois qui ont suivi, à des mesures politiques exceptionnelles pour endiguer la pandémie. Les confinements de la population à trois reprises entre le printemps 2020 et le printemps 2021, et la campagne massive de vaccination, accompagnée d’un passe sanitaire puis vaccinal de juin 2021 à l’été 2022, ont eu des conséquences sociales majeures, que plusieurs programmes de recherche se sont employés à documenter, notamment le programme « Flash COVID-19 » de l’ANR en 20201.
Parmi ceux-là, le projet de recherche Vico2, s’est donné pour objectif d’étudier sur le temps long l’ampleur des changements causés par la pandémie, à partir d’une enquête en méthodes mixtes. L’ambition scientifique de la recherche était structurée autour d’une question centrale : comment la crise sanitaire a-t-elle affecté, dans la durée, les relations entre les personnes, les collectifs et les institutions ? Le second objectif visait à prendre la mesure des articulations entre ces transformations des liens sociaux d’une part et les évolutions dans un certain nombre de domaines fondamentaux de la vie sociale d’autre part. Ainsi, dans le domaine du travail, comment les bouleversements des pratiques professionnelles ont-ils interagi avec les modifications des relations de travail, notamment avec le développement du télétravail ? Ou, dans le domaine des pratiques culturelles, la désaffection des équipements culturels a-t-elle été le produit ou la cause du repli de la sociabilité sur les relations familiales, au détriment des relations amicales ? Et quels ont été les effets de ces resserrements et recompositions des liens sociaux sur les rapports à l’État et à la politique ?
Pour répondre à ces questions, le programme était structuré en trois axes de recherche, coordonnés par trois laboratoires : l’Axe 1 « Pratiques professionnelles et relations de travail » est porté par l’équipe du LEST (UMR CNRS 7317), l’Axe 2 « Vie quotidienne, vie familiale, pratiques culturelles et usages numériques » par le laboratoire Pacte (UMR CNRS 5194) et l’Axe 3 « Bouleversements des parcours de vie, vulnérabilités, rapports à l’incertitude, à l’avenir, à l’autorité et à l’Etat » par le LISST (UMR CNRS 5193). Depuis mai 2020, un « panel » de plusieurs milliers de personnes, recruté au moment du premier confinement du printemps 2020 et renouvelé à l’automne 2024, répond régulièrement à des questionnaires en ligne sur les effets à long terme de la crise sanitaire sur différentes sphères de la vie sociale telles que les relations personnelles, le rapport au travail, au logement, à l’autorité de l’Etat. Ces questionnaires répétés ont été complétés par plusieurs campagnes d’enquêtes thématiques par entretien auprès des membres du panel.
Ces recherches ont déjà permis à notre équipe de documenter un certain nombre de transformations du lien social depuis la pandémie, et leurs conséquences dans ces différents domaines de la vie sociale3. Ces résultats n’exploitent toutefois qu’une partie des données produites par le programme de recherche Vico, ce qui conduit au choix de les ouvrir à la communauté scientifique pour en permettre des analyses complémentaires4. Une première présentation de cette recherche a déjà été publiée, pour restituer l’implémentation du dispositif d’enquête, les difficultés inhérentes au suivi d’un panel longitudinal et les choix méthodologiques opérés par l’équipe (Bidart, Machut, et al., 2024). Le présent article, pour sa part, se donne pour objectif principal de présenter les jeux de données issus de cette enquête, sans revenir en détail sur l’histoire du dispositif empirique. Ces jeux de données sont mis à disposition au sein de la collection « Les conditions de vie et les relations sociales, avant, pendant et après les confinements (VICO) » de la banque de données du Centre de Données Socio-Politiques de Sciences Po, à l’adresse suivante : https://data.sciencespo.fr/dataverse/vico. Cette collection rassemble à ce jour les quatre premières vagues de questionnaires en ligne, une « table des alters » (voir infra) et 206 entretiens menés en 2021 et 2022 portant sur les transformations des relations sociales (90 entretiens), les incertitudes (50 entretiens) et les vulnérabilités exprimées (29 entretiens) pendant la pandémie, les usages des technologies d’information et de communication (28 entretiens) et le télétravail (9 entretiens). À l’heure actuelle, deux autres campagnes d’entretiens sont en cours de réalisation, une sur la question des loisirs et de la culture, et une autre sur le rapport au travail et les relations professionnelles. Elles feront l’objet d’un dépôt et d’un data paper ultérieurs, comme les quatre vagues d’enquêtes par questionnaire supplémentaires réalisé
es depuis 2024 auprès du panel rafraîchi.
I. Présentation de l’enquête : un panel créé dans l’urgence de la crise sanitaire de Covid-19
I.1. Les enquêtes quantitatives par questionnaire en ligne
A. L’enquête par questionnaire du printemps 2020 : documenter « à chaud » les conséquences sociales de la crise sanitaire
Le projet Vico a vu le jour au printemps 2020, pendant les premières semaines du premier confinement français. En même temps que la recherche en sciences expérimentales cherchait activement un vaccin contre le virus, que l’industrie réorientait une partie de sa production vers les masques chirurgicaux, les gels hydro-alcooliques et les respirateurs, une équipe de chercheur·es en sciences sociales spécialistes des réseaux sociaux a entrepris de fabriquer une enquête quantitative pour documenter en temps réel les conséquences sociales de l’épidémie et des mesures sanitaires pour y faire face : l’enquête Vico, pour la VIe en COnfinement.
Le questionnaire de cette première enquête comportait, outre des questions sur les principales caractéristiques socio‐démographiques des participant·es, des modules sur les différents aspects de la vie sociale affectés par la crise : les conditions de logement et la situation professionnelle avant et pendant le confinement, les activités domestiques quotidiennes, les pratiques sanitaires spécifiques (port du masque, sorties…), les transformations des réseaux personnels et des modes de contact avec les proches pendant le confinement. Dans la perspective de la sociologie des réseaux, il comportait en particulier des générateurs de noms permettant aux personnes enquêtées de citer nommément leurs proches et le type de relation entretenue avec elles et eux. Le questionnaire a été auto-administré en ligne (CAWI) avec la plateforme LimeSurvey5.
La diffusion de l’enquête s’est faite d’abord par les réseaux universitaires, auprès des étudiant·es et des enseignant·es, sur les listes professionnelles et les réseaux sociaux, puis en mobilisant la presse quotidienne régionale de différentes régions de France métropolitaine (93 journaux locaux en tout). La passation a eu lieu entre le 15 avril et le 11 mai 2020 auprès de répondant·es majeur·es – la clôture ayant eu lieu au dernier jour du premier confinement. L’échantillon retenu pour la diffusion des données comporte... comporte 15 543 réponses complètes et non aberrantes. S’il n’est pas exactement représentatif de la population française (en particulier, les non-bacheliers, les ouvriers, les hommes et les plus de 65 ans sont sous-représentés, et dans une moindre mesure les personnes qui ne se définissent pas à gauche politiquement), cet échantillon est suffisamment vaste pour se prêter à un redressement statistique (voir section III.2 ci-dessous).
Parmi les répondant·es à ce questionnaire inaugural – qui est devenu, a posteriori, la Vague 1 (V1) de l’enquête, 5 661 ont accepté d’être recontacté·es dans le cadre d’un questionnaire suivant ou d’un entretien. C’est ce taux très important de réponses positives qui a permis de transformer l’échantillon de personnes ayant laissé leurs coordonnées en un panel de répondant·es acceptant d’être réinterrogés à plusieurs reprises. Il ne s’agit donc pas d’un panel préexistant en population générale auquel des questions supplémentaires auraient été soumises à l’occasion de la crise, mais bien d’un panel constitué spécifiquement à l’occasion de cette première enquête, parce que le grand nombre de réponses ouvrait la possibilité d’un suivi longitudinal original en méthodes mixtes. La possibilité d’apparier les données quantitatives issues des vagues de questionnaires et les données qualitatives issues des entretiens a été maintenue pour le dépôt des données auprès du CDSP, via l’identifiant de panel (idpanel).
Figure 1 : Calendrier des différentes phases de l’enquête longitudinale Vico

B. Les enquêtes ultérieures auprès du panel d’enquêté·es
La première vague de l’enquête a été suivie par trois vagues supplémentaires, toujours par questionnaire en ligne, réalisées auprès des répondant·es ayant accepté d’être recontacté·es (Tableau 1). La deuxième enquête par questionnaire (V2) a ainsi été administrée entre le 17 décembre 2020 et le 31 janvier 2021, à un échantillon final de 3 267 personnes. Elle reprenait de nombreuses questions de la première vague, pour documenter les transformations survenues dans le domaine du logement, du travail et des relations personnelles entre le premier et le deuxième confinement.
La troisième enquête par questionnaire (V3) a été administrée entre le 17 décembre 2021 et le 31 janvier 2022, à un échantillon final de 2 477 personnes. Elle poursuivait la logique des deux premières vagues, en documentant les changements de situation vis‐à‐vis du logement et du travail, les usages numériques, le rapport à la vaccination et au passe sanitaire, les usages du temps libre, les conflits et nouveaux contacts survenus durant l’année 2021.
La quatrième enquête par questionnaire (V4) a été administrée entre le 27 juillet 2023 et le 25 janvier 2024, à un échantillon final de 1 669 personnes. Il s’agissait là encore de documenter les évolutions de la situation personnelle, résidentielle et professionnelle des répondant·es, leur opinion rétrospective sur la gestion de la crise sanitaire et les transformations de leurs relations personnelles à partir de trois « générateurs de noms » portant sur les problèmes personnels, les services domestiques et les activités partagées au cours des trois derniers mois.
Tableau 1 : Les quatre vagues de l’enquête par questionnaire

NB : les retours après interruptions correspondent aux réponses à une vague après une absence de réponse lors de la vague précédente. Le taux de réponse correspond au rapport entre le nombre de questionnaires retenus et le nombre de questionnaires envoyés. Dans la population de référence (personnes âgées de 18 ans et plus résidant habituellement en France métropolitaine), les proportions de femmes, de moins de 65 ans et de diplômé·es du supérieur sont respectivement de 51 %, 75 % et 30 % (source : Insee, enquête Emploi, 2018).
Entre la première et la quatrième vague, l’attrition, différenciée selon les caractéristiques sociales des répondant·es, a accentué la déformation de l’échantillon (voir section 3.1 ci-dessous). Au total, 1 218 répondant·es ont participé à la totalité de ces quatre enquêtes par questionnaire (c’est le « cylindre » du corpus longitudinal diffusé). Si la majorité des sorties entre deux vagues sont définitives, quelques enquêté·es peuvent « sauter » une vague, ou revenir ponctuellement (Figure 2).
Figure 2 : Trajectoire de participation des enquêté·es aux différentes vagues d’enquête Vico

Source : Enquête Vico, questionnaires des Vagues 1 à 4 (2020-2024).
Pour résumer, on peut distinguer de façon longitudinale trois types d’échantillons. Le premier et le plus large est constitué de l’ensemble des répondant·es de la première vague (V1), soit 15 542 individus. Le deuxième correspond aux répondant·es de cette V1 qui ont accepté d’être recontacté·es et qui ont été retenu·es dans le premier échantillon (N = 5 392, identifiables par la variable CONTACT_bin) : ils et elles constituent le panel initial de l’enquête Vico, avant le rafraîchissement de 2024. Enfin, le troisième correspond au cylindre longitudinal des 1 218 individus ayant renseigné des questionnaires complets à chacune des quatre premières vagues de l’enquête. Le dépôt des données ne propose pas de fichier distinct correspondant à ce cylindre, mais il peut être facilement reconstitué en appariant les bases des quatre premières vagues de l’enquête. La base ainsi obtenue peut être utilisée pour des analyses longitudinales sur l’ensemble de la période, soit à partir des données brutes, soit en calculant des poids longitudinaux (non fournis dans le dépôt des données) par exemple par calage sur les marges des mêmes variables que celles utilisées pour le redressement de la Vague 1 (Joubert et al., 2023).
I.2 Les enquêtes par entretien
Parallèlement à ces enquêtes par questionnaire, plusieurs campagnes d’enquêtes par entretien ont été menées auprès des membres du panel Vico (Tableau 2), pour approfondir de façon qualitative les réponses fournies dans les questionnaires. Pour des raisons sanitaires, les entretiens ont été menés principalement par téléphone ou en visioconférence – quelques-uns ont pu l’être en face-à-face après l’allègement des restrictions sanitaires. Chaque enquête était coordonnée par un sous-groupe de collègues qui focalisait son attention sur sa thématique principale, en fonction des intérêts de recherche de chacun·e, mais les entretiens pouvaient intégrer un module plus bref de questions sur les thématiques d’autres enquêtes qualitatives en cours au sein de notre équipe de recherche. Un tirage aléatoire d’enquêté·es répondant aux critères d’inclusion formulés par les chercheur·ses était réalisé au sein du panel, en veillant à éviter la sursollicitation (concrètement, une personne rencontrée pour un entretien n’était pas sollicitée de nouveau, sauf si elle y consentait). Les caractéristiques de ces tirages de même que celles des enquêteur·ices, la durée des entretiens, la composition de l’échantillon et les modalités de retranscriptions sont systématiquement détaillées dans la documentation qui accompagne chaque enquête.
Tableau 2 : Les enquêtes par entretien (2020 – 2022)

Nous avons réalisé une analyse des correspondances multiples (ACM) pour indiquer les positions des personnes interrogées par entretiens dans l’espace social de la totalité des répondant·es de la première vague de l’enquête par questionnaire qui avaient laissé des coordonnées permettant de les solliciter. Les variables actives de cette ACM décrivent les ressources économiques et sociales des panélistes, comprises au sens large (Cayouette-Remblière et al., 2021) : genre, âge, lieu de naissance, situation conjugale, diplôme, catégorie socioprofessionnelle, lieu de résidence, et fréquence de la sociabilité amicale. Dans cet espace social des panélistes structuré dans l’ensemble par l’âge (dimension 1, avec les moins de 40 ans à l’ouest et les 60 ans et plus à l’est) et par la position dans la hiérarchie sociale (dimension 2, avec les classes favorisées dans la partie sud du graphique), il apparaît que les campagnes d’entretiens ont plutôt ciblé les jeunes actif·ves et diplômé·es que les inactif·ves plus âgé·es, mais avec des différences liées aux critères d’inclusion (Figure 3) : par exemple, les entretiens « Incertitudes », « Relations » et « Télétravail » ont porté sur un sous-échantillon d’âge moyen plus actif et diplômé, les entretiens « TIC » ont plutôt ciblé les classes moyennes, et les entretiens « Vulnérabilités » ont ciblé des panélistes disposant dans l’ensemble de ressources sociales plus faibles que les autres.
Figure 3 : Les positions des enquêté·es par entretien dans l’espace social des panélistes

Source : Enquête Vico, questionnaire de la Vague 1 et campagnes d’entretiens (2020-2022).
II. Présentation détaillée des jeux de données de la collection Vico
II.1. Protection des données, confidentialité et accès aux données
L’ouverture des données produites dans le cadre des ANR Vico et Panelvico était prévue dès le dépôt des candidatures auprès de l’ANR. Elle s’appuie à la fois sur le consentement des enquêté·es à la diffusion de leurs données pseudonymisées et sur la mission d’intérêt public du projet, qui dispose du certificat d’enregistrement obtenu le 15 mai 2020 sous le numéro 2-20051. Les choix d’anonymisation et de pseudonymisation ont été réalisés de façon concertée au sein de l’équipe de recherche et en dialogue avec le Délégué à la Protection des Données du CNRS (Thizy, Mercklé, 2026), en prenant pour acquis que la distinction entre l’anonymisation (irréversible) et la pseudonymisation (où il demeure possible de réidentifier la personne en croisant différentes informations) relève d’un continuum tributaire des données disponibles par ailleurs, des techniques de croisement mobilisables et des moyens qu’un tiers pourrait engager pour réidentifier une personne plutôt que de deux états distincts (Brunel, Danciu et Lamrini, 2023). Dans ce qui suit, nous présentons les arbitrages réalisés pour préserver la confidentialité des répondant·es tout en limitant la dégradation de la qualité des données.
Les données sont accessibles dans la collection « Les conditions de vie et les relations sociales, avant, pendant et après les confinements (VICO) » du Centre de Données Socio-Politiques6, à l’adresse suivante : https://data.sciencespo.fr/dataverse/vico. Le CDSP est responsable de la conservation des données et de la compilation des métadonnées.
Pour chaque vague de questionnaire et chaque campagne d’entretiens, la documentation des données est en accès libre, téléchargeable sur le site du CDSP après acceptation des conditions d’utilisation. Les données elles-mêmes sont accessibles sur demande sous 48 heures aux chercheur·ses, aux enseignant·es et aux étudiant·es disposant d’une adresse électronique universitaire et après la création d’un compte data.sciencespo.fr. La licence CC BY-NC-ND 4.0 appliquée à ces données de recherche autorise leur libre copie et diffusion, à condition de créditer les auteur·ices, de ne pas en faire un usage commercial et de ne pas les modifier ni les intégrer dans des travaux dérivés (par exemple sous forme de jeux de données transformés ou d’analyses redistribuées). Les utilisateur·ices sont personnellement et financièrement responsables de tout usage non conforme aux licences. En particulier, les fichiers peuvent contenir des données personnelles, utilisables uniquement à des fins de recherche et d’enseignement.
L’utilisation de tout ou une partie des jeux de données de l’enquête VICO doit s’accompagner de la citation du présent article et du ou des DOI des jeux de données utilisés. Pour toute information complémentaire, vous pouvez contacter l’équipe de recherche à l’adresse suivante : pacte-contact-panelvico@univ-grenoble-alpes.fr.
II.2. Organisation et traitement des données quantitatives
Chaque vague d’enquête par questionnaire dispose de son propre DOI :
- V1 : https://doi.org/10.21410/7E4/L00E85
- V2 : https://doi.org/10.21410/7E4/CZNKZO
- V3 : https://doi.org/10.21410/7E4/CCSORQ
- V4 : https://doi.org/10.21410/7E4/QNGM83
Dans une perspective classique en sociologie des réseaux, ces vagues d’enquête par questionnaire incluaient la mention « d’alters » cités par les répondant·es dans des générateurs de noms. Des interpréteurs de noms permettent de déterminer, pour chaque personne citée, le type de lien avec cette personne (père ou mère, frère ou soeur, conjoint, ami∙e, collègue, etc.), son genre, son âge, sa situation conjugale, son nombre d’enfants, l’ancienneté de la relation, la fréquence des contacts, etc. Nous avons anonymisé ces alters en supprimant leur prénom ou pseudo en clair et en le remplaçant par un numéro unique, créé à partir de l’identifiant du répondant (« ego ») qui les a mentionnés. Pour faciliter l’analyse, nous mettons à disposition une table des alters dans une sous-collection dédiée : https://doi.org/10.21410/7E4/VGJOLT. Celle-ci contient au total 67 686 individus et 73 variables, décrivant leurs caractéristiques et les caractéristiques des relations que les répondant∙es entretiennent avec ces personnes.
Chaque vague de questionnaire s’organise selon la même logique. Le jeu de données correspondant comporte à chaque fois :
La documentation détaillée en accès libre de l’enquête (intitulé sous la forme Documentation_VICOX_Année.pdf), qui inclut une présentation générale du projet Panelvico et de son financement, une présentation détaillée de la vague incluant l’échantillonnage (procédure, taux de réponse et biais), le redressement (méthodes et coefficients de pondération), le mode de collecte des données, leur anonymisation et le dictionnaire des variables dans son intégralité.
Le questionnaire en accès libre (intitulé sous la forme Questionnaire_VICOX_Année.pdf).
Les données en différents formats .csv, .rds et .sav. Celles-ci incluent chaque fois, outre les variables des différentes vagues :
un talon socio-démographique reconstitué par nos soins7, avec les variables suivantes : sexe, âge par tranches quinquennales (calculé à la date de l’enquête), type de logement, situation professionnelle, PCS recodée, situation conjugale et niveau de diplôme, signalées par le suffixe _PANEL.
Les 5 variables de calage utilisées pour le redressement (voir 3.2), signalées par le suffixe _cal.
Les valeurs manquantes, quelle que soit leur nature (absences ou refus de réponses, questions non-applicables ou filtrées) sont toutes codées de façon identique, en utilisant le codage des valeurs manquantes spécifique à chaque format, comme par exemple NA (pour Not Available) pour le format R. Nous n’avons pas introduit de bruit aléatoire dans les données ni réalisé d’imputation des non-réponses, sauf pour le redressement. Le travail d’anonymisation mené sur les données brutes a consisté à supprimer ou recoder les variables directement ou indirectement identifiantes et anonymiser les questions ouvertes.
Nous avons retiré les variables relatives à l’administration du questionnaire (identifiant d’invitation, date, heure et langue de réponse…), les variables comportant les coordonnées des répondant·es (mail de contact, numéro de téléphone) et les variables trop directement identifiantes (profession, commune de résidence, année de naissance en clair).
Pour les variables indirectement identifiantes8, nous avons choisi de procéder par regroupement de modalités et recodages de variables :
- La religion a été recodée en deux modalités : avoir ou non une religion.
- L’information géographique disponible la plus précise est la ZEAT, qui distingue 8 catégories de régions.
- L’âge est disponible en tranches quinquennales.
- Le niveau de diplôme est disponible en 5 catégories dans la variable DIPLONIV et la catégorie socioprofessionnelle auto-déclarée est disponible en 9 catégories dans la variable PCS.
Chaque vague d’enquête quantitative comportait des questions ouvertes pour permettre aux enquêté·es de s’exprimer librement sur des thématiques plus larges et moins directives. La période de crise sanitaire, particulièrement éprouvante, a conféré à ces espaces d’expression une fonction parfois cathartique et certain·es répondant·es ont pu fournir des récits détaillés de leurs conditions de vie, de leur état de santé ou de leurs relations personnelles. Un strict travail de pseudonymisation était donc indispensable. Pour des raisons techniques, nous avons choisi de supprimer les données directement ou indirectement identifiantes des questions ouvertes, en signalant cette suppression par [...]9. Ces choix de suppression ont été discutés en équipe à partir d’une règle établie comme suit : nous avons systématiquement supprimé des questions ouvertes les localisations (communes, régions et départements, pays, régions du monde…), les temporalités (années, dates précises, durées, âges et anniversaires…), les noms propres (prénoms de connaissances, noms d’entreprises et d’enseignes…), les sigles ou acronymes trop rares ou trop identifiants, les maladies rares ou peu communes (ex : « mucoviscidose ») et les types de handicap (mental, physique etc.). Nous avons pu aussi, au cas par cas, raccourcir un certain nombre d’informations cumulées qui, mises bout à bout, augmentaient le risque de réidentification10.
Nous n’avons pas directement mis à disposition les scripts R qui réalisent pour chaque vague d’enquête l’ensemble de ces opérations de préparation et de documentation des données à partir des données brutes des réponses aux questionnaires en ligne, car ils contiennent des informations permettant la réidentification des répondant·es. Néanmoins, les personnes qui souhaiteraient accéder à certaines parties non identifiantes de ces scripts pour examiner dans le détail ces opérations, ou les reproduire, peuvent les solliciter directement auprès des coordinateur·ices du programme de recherche en écrivant à l’adresse pacte-contact-panelvico@univ-grenoble-alpes.fr.
II.3. Organisation et traitement des données qualitatives
De même, chaque campagne d’enquête par entretien dispose de son propre DOI :
Relations sociales en temps de confinement (Relations, 2021) : https://doi.org/10.21410/7E4/OUHGGR
Les usages des technologies de l’information et de la communication pendant le confinement (TIC, 2021) : https://doi.org/10.21410/7E4/KWUQHN
Les vulnérabilités causées par la crise sanitaire de 2020 (Vulnérabilités, 2021) : https://doi.org/10.21410/7E4/RLALTR
Les effets des incertitudes liées à l’emploi sur les parcours de vie (Incertitudes, 2021) : https://doi.org/10.21410/7E4/LS8MUE
L’articulation entre télétravail et travail domestique (Télétravail, 2022) : https://doi.org/10.21410/7E4/PSHD3B
Le jeu de données correspondant comporte à chaque fois :
La documentation de l’enquête (intitulé sous la forme VICO_NOM DE LA CAMPAGNE_DOCUMENTATION) qui inclut une présentation du contexte de l’enquête, des entretiens et du guide d’entretien (en accès libre).
Un document PDF qui récapitule les caractéristiques des entretiens menés (intitulé sous la forme VICO_NOM DE LA CAMPAGNE_Fiches_entretiens) qui comporte les principales données socio-démographiques, le contexte de passation et le cas échéant un résumé de l’entretien (sur demande). Ces résumés ont été écrits par les personnes ayant réalisé les entretiens.
les retranscriptions intégrales pseudonymisées (intitulé sous la forme fr_cdsp_vico_nom de la campagne_entretien_identifiant de panel de l’enquêté·e.odt, à raison d’un document au format .odt par entretien (sur demande). Le nom du fichier correspondant à l’identifiant de l’enquêté·e dans les données quantitatives (variable idpanel). Ces retranscriptions n’incluent pas les métadonnées sur les entretiens (accessibles dans le document récapitulatif) pour permettre facilement des traitements lexicométriques.
Pour la pseudonymisation des entretiens, la technique de suppression des informations appliquée aux questions ouvertes n’a pas été utilisée : elle aurait engendré une perte d’informations cruciales pour la compréhension et l’analyse. La protection des répondant·es a été assurée en recourant préférentiellement à l’hyperonymie (remplacement de l’entité nommée par une catégorie plus générale indiquée entre crochets) et à la substitution (remplacement de l’entité nommée par une autre aux propriétés sociodémographiques équivalentes).
L’hyperonymie a été utilisée pour anonymiser les lieux, les entreprises et les difficultés de santé qui touchent moins de 5 % de la population (Thizy et Mercklé, 2026). Le choix de la catégorie plus générale a été fait au cas par cas pour chaque entretien, de façon à préserver prioritairement la cohérence interne de l’énonciation – ce qui contribue à invisibiliser un certain nombre de caractéristiques des entités nommées. Autant que possible, si une même entité apparaissait dans plusieurs entretiens, nous l’avons anonymisée de la même façon grâce à une table de correspondance non diffusée. Un tel procédé empêche toutefois des réusages qui porteraient sur un même lieu ou une même entreprise, puisque plusieurs lieux ou entreprises présentant des caractéristiques similaires ont pu être anonymisés de la même façon dans différents entretiens. Nous avons conservé en clair les difficultés de santé qui touchent plus de 5 % de la population comme l’endométriose ou le Covid.
Pour alléger la lecture, les prénoms et – le cas échéant – les noms des personnes mentionnées pendant l’entretien ont, quant à eux, fait l’objet d’une substitution. Ils ont été remplacés par des prénoms et noms aux propriétés sociales équivalentes en termes de réussite au baccalauréat, grâce à l’outil mis à disposition par Baptiste Coulmont11, mais aussi en termes de pic de popularité à une époque donnée, d’après les données de l’INSEE, de façon à donner une idée de la génération des répondant·es.
Dans le cas spécifique de la campagne « Relations », dont les entretiens s’appuyaient sur les réponses préalablement données au questionnaire, et en particulier sur les « alters » cités dans les générateurs de noms, nous avons ajouté entre crochets le numéro d’Alter correspondant dans la « table des alters » mise à disposition.
Enfin, certaines portions d’entretiens jugées trop identifiantes parce qu’elles entraient dans le détail avec trop de précisions et de spécificités ont été supprimées ou résumées par nos soins. Ces coupes ou résumés sont indiqués entre crochets.
II.4. Valoriser les réusages d’enquête longitudinale en méthodes mixtes
La grande originalité de nos données est de permettre des analyses longitudinales en méthodes mixtes (Bidart, Bozouls, et al., 2024). Dans toutes les vagues d’enquête par questionnaire et dans toutes les campagnes d’entretiens, chaque réponse est identifiée par un identifiant individuel unique qui se trouve dans la variable « idpanel » (pour les données quantitatives) ou qui est indiqué au début des fiches d’entretiens et dans le nom des fichiers des transcriptions (pour les données qualitatives). De cette façon, il est possible d’apparier les vagues d’enquêtes par questionnaire entre elles, pour suivre des évolutions individuelles des réponses aux questions posées dans des termes identiques dans différentes vagues – comme le fait par exemple Simon Paye (2021) pour analyser les évolutions de la pression temporelle pendant la crise sanitaire – ou pour analyser les liaisons statistiques entre des réponses à des questions appartenant à des vagues différentes ; et il est possible également d’apparier les transcriptions d’entretiens avec des panélistes à leurs réponses à des questions des enquêtes par questionnaire.
III. Apports et limites des données de l’enquête Vico
III.1. Attrition, déformation et rafraîchissement du Panel Vico
Le panel constitué à partir de la première vague de l’enquête, réalisée au printemps 2020 à partir d’un échantillon spontané, présentait dès l’origine d’importantes distorsions en faveur des femmes et des personnes les plus diplômées. L’attrition sélective a eu tendance à renforcer cette dynamique, en accentuant la sous-représentation de plusieurs catégories de la population : en particulier, la proportion de diplômé·es du supérieur passe de 69 % en V1 à 78 % en V4, au lieu des 30 % attendus ; la proportion d’ouvrier·es passe de 4 % en V1 à 3 % en V4 au lieu des 17 % attendus ; et la proportion de moins de 65 ans passe de 87 % en V1 à 93 % en V4, au lieu des 75 % attendus. Cette distorsion a un effet sur les résultats produits : quelles que soient les futures analyses menées à partir des données proposées, nous invitons à la réflexivité et à la vigilance méthodologique sur ce point.
Pour remédier à cette attrition sélective, le panel a été rafraîchi au cours de l’année 2024 avec l’inclusion de 6 148 nouveaux et nouvelles répondant·es, via un questionnaire de Vague 4 augmenté de questions socio-démographiques. Les modalités et les résultats de ce rafraîchissement, ainsi que les données issues des vagues de questionnaires ultérieures12, feront l’objet d’une présentation future lors de leur dépôt auprès du CDSP.
III.2. Redressement
Pour chaque vague d’enquête par questionnaire, les données ont fait l’objet d’un redressement, dont les modalités sont présentées et discutées en détail dans un article publié dans le Bulletin de méthodologie sociologique (Joubert et al., 2023). Certains groupes trop petits pour être représentés, ou avec des propriétés biaisant trop l’échantillon, ont été affectés d’un coefficient de pondération nul (autrement dit, ils sont retirés de l’échantillon redressé) : il s’agit des genres « autres » ; des femmes ayant répondu à l’enquête à la demande de leur mari ; des habitant·es des outremers. Les autres répondant·es ont été affecté∙es d’un coefficient de pondération calculé par une procédure de calage sur les marges des variables de sexe, âge, ZEAT, taille de l’unité urbaine et PCS de l’Enquête Emploi 2018, après imputation des non-réponses partielles pour ces variables dans l’enquête selon les recommandations de Neiter et Buisson (2010). Le coefficient de pondération ainsi calculé (variable POIDS_init en V1, POIDS_V2 en V2, POIDS_V3 en V3 et POIDS_V4 en V4) est nul pour les individus retirés de l’échantillon final, et prend une valeur comprise entre 0,19 et 6,63 pour les autres. Cet échantillon redressé peut être considéré comme représentatif des 18‐74 ans ayant accès à internet. Il ne corrige cependant pas le biais introduit par l’absence d’accès ou d’utilisation du numérique, ni les biais relatifs au positionnement politique, et marginalement ceux relatifs au niveau d’études. Nous n’avons pas non plus calculé de poids longitudinaux.
III.3. Principaux résultats du programme de recherche
En s’appuyant sur ces données, le programme de recherche Vico a déjà donné lieu à de nombreuses publications. Elles ont permis d’établir d’abord que la crise sanitaire a causé des perturbations massives des activités sociales (Mariot, Mercklé et Perdoncin, 2021), et qu’elle a très majoritairement été vécue comme une épreuve caractérisée par de très importantes difficultés de tous ordres (Cardon, Machut et Perdoncin, 2023) plutôt que comme une pause bienvenue ou l’occasion heureuse d’expérimenter une autre façon de vivre, même dans la population socialement favorisée couverte par le panel. Le recentrage sur le logement a conduit de nombreux jeunes, notamment parmi les étudiant·es, à rejoindre le domicile de leurs parents, tandis que d’autres foyers ont vu partir certains de leurs membres pour des raisons très diverses : au total, c’est environ un cinquième des personnes qui ont été confrontées à une reconfiguration temporaire du foyer. La vie confinée a impliqué de multiples ajustements dans l’organisation familiale, le partage des tâches domestiques et éducatives. Les femmes ont absorbé la plus grande part de l’accroissement des tâches (Charlap, 2021), tout en étant très investies dans le maintien des relations sociales, lesquelles se sont recentrées sur les entourages familiaux et les liens les plus forts, tandis que les sociabilités des jeunes étaient fortement entravées par l’arrêt de nombreuses activités qui constituaient habituellement les contextes dans lesquels les relations se créent et s’entretiennent.
Malgré les politiques de préservation de l’emploi et des revenus, certaines personnes ont rencontré des difficultés professionnelles importantes, notamment les « petit·es indépendant·es » qui vivaient de services peu formalisés, ou les précaires de certains métiers. Et sur le plan politique, si les mesures décidées par le gouvernement ont suscité de nombreuses critiques, notamment de la part des personnes dont les positions politiques étaient déjà hostiles à celles du gouvernement, d’une part elles ont été globalement respectées (Boulakia et Mariot, 2023), et d’autre part les personnes qui s’en sont affranchies le plus fortement ne sont pas celles qu’on a souvent pointées du doigt : plutôt les ruraux que les citadins et les habitant·es des quartiers populaires, et plutôt les personnes âgées que les jeunes…
La période qui a suivi le premier confinement a été marquée par diverses formes de restrictions des libertés de réunion et de circulation, qui ont continué à perturber de nombreuses activités, au travail comme à la maison et dans les loisirs, et engendré des situations de précarité économique, sociale et familiale marquées, et des sentiments très forts d’incertitude et de fatigue. Les relations interpersonnelles qui avaient été affectées durant le premier confinement le sont en majorité restées ensuite, ce qui a pérennisé certaines modifications des réseaux personnels, devenus plus restreints et plus homogames, c’est-à-dire composés de personnes ayant des caractéristiques sociales (de genre, d’âge, de niveau de diplôme, de milieu social…) plus semblables qu’avant la crise (Grossetti et al., 2023). Ce resserrement a en outre favorisé un repli dans l’entre-soi des discussions avec des personnes ayant des positions idéologiques convergentes (Figeac et al., 2024).
Les dernières vagues de l’enquête Vico (en 2023 et 2024) ont montré des formes inachevées de « retour à l’ordinaire », avec la levée de la plupart des contraintes. La pression temporelle redevient pratiquement ce qu’elle était avant la crise, les processus relationnels (création, maintien, dissolution des relations) ont retrouvé leurs dynamiques ordinaires, les jeunes se remettant à créer de nombreuses relations dans des contextes de sociabilité retrouvés.
III.4. Vico dans le paysage des enquêtes sur la crise sanitaire
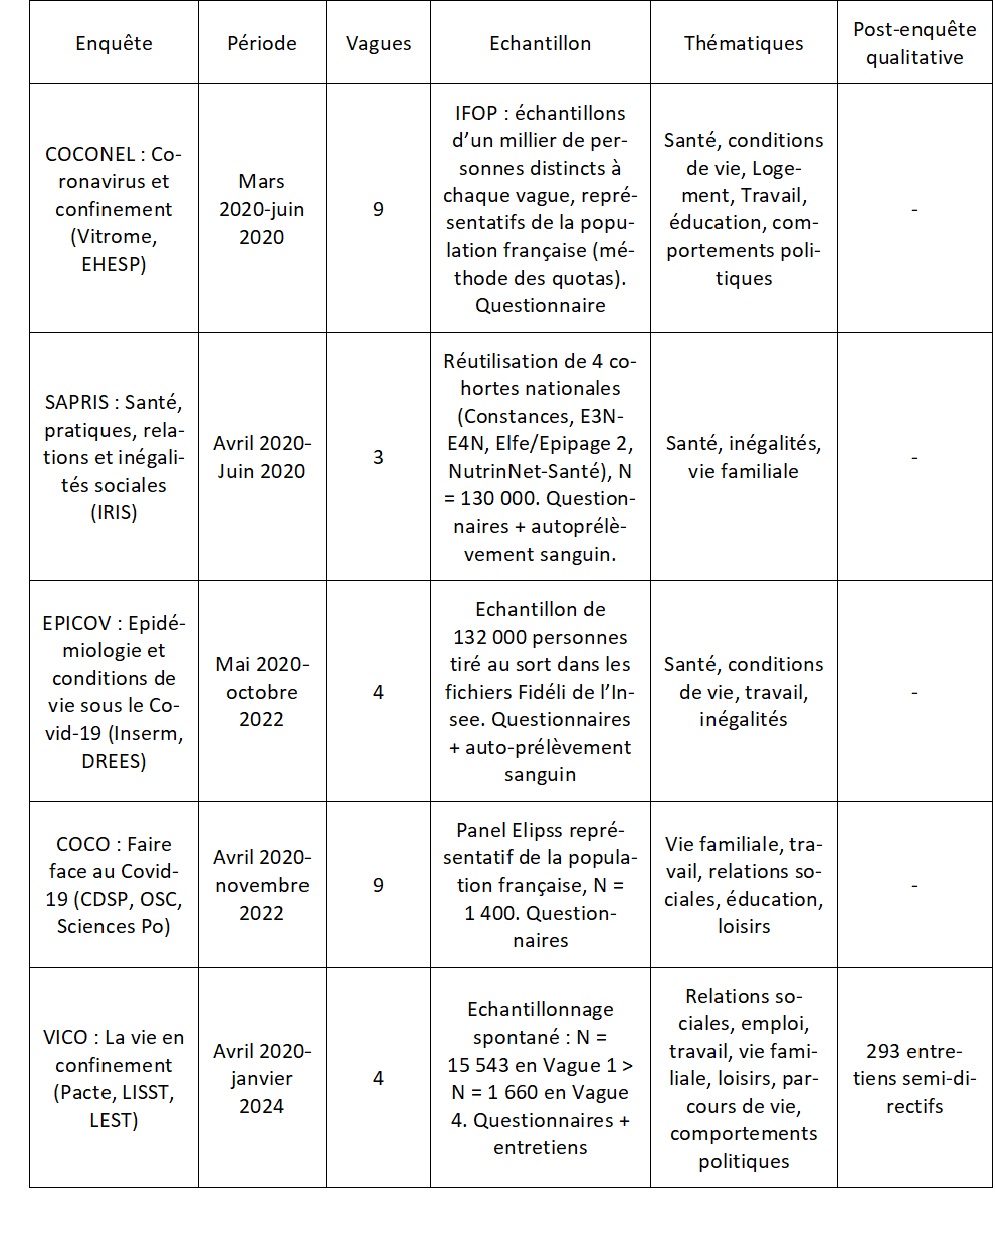
Ces données et ces résultats inscrivent l’enquête Vico dans un ensemble plus vaste de recherches qui se sont parallèlement employées à documenter (Tableau 3) : le programme « Flash COVID-19 » de l’Agence nationale de la recherche (ANR), dans le cadre duquel notre enquête a été financée, a aussi financé notamment l’enquête Coconel (Coronavirus et Confinement, voir Peretti-Watel, 2022), le projet Coco (« Faire face au Covid-19 : Distanciation sociale, cohésion, et inégalité dans la France de 2020 », CDSP et OSC), et le projet Sapris (« Santé, pratiques, relations et inégalités sociales en population générale pendant la crise Covid-19 »), qui a ensuite donné lieu à la cohorte EpiCov (Epidémiologie et Conditions de vie sous le Covid-19), coordonnée par l’Inserm et la DREES (Dufour, 2024).
Les données de l’enquête Vico s’inscrivent dans ce panorama en apportant des éclairages complémentaires qui tiennent à leurs spécificités : elles sont en particulier les seules en population générale et en méthodes mixtes à couvrir par une enquête longitudinale une période aussi longue, qui s’étend du début du premier confinement jusqu’à plusieurs années après la fin de la crise sanitaire, et les seules également à apporter des éclairages sur les transformations des relations sociales et leurs mécanismes sur cette longue période.
Tableau 3. Les principales enquêtes sur la crise sanitaire en population générale
Le dépôt des données de l’enquête Vico s’inscrit dans une démarche de science ouverte délibérée, prévue et programmée dès l’origine du projet de recherche en 2020. La recherche d’un impact fort sur le débat public avait conduit initialement l’équipe de recherche à favoriser une mise en œuvre maximale des principes FAIR (facilité à trouver, accessibilité, interopérabilité, réutilisation). Cette ambition s’était traduite dès la fin du printemps 2020, quelques jours après la fin du premier confinement, par un « datathon » en distanciel qui avait débouché sur la publication, moins d’un an plus tard, de l’ouvrage collectif Personne ne bouge (Mariot, Mercklé et Perdoncin, 2021) présentant les premières analyses des résultats de l’enquête. Elle avait conduit ensuite, en collaboration avec les Plateformes Universitaires de Données (PUD)13 associées au projet, au développement de plusieurs formations aux méthodes quantitatives en sciences sociales sur la base des données collectées par l’enquête Vico, et au développement et à la diffusion de « kits pédagogiques » adossés à des extraits de ces données.
Nous invitons donc vivement la communauté scientifique à se saisir à son tour de ces données pour prolonger ces différentes initiatives. Sur le plan scientifique, elles constituent un exemple rare de documentation empirique « à chaud » et en méthodes mixtes d’une crise sociale majeure, dont les données permettent d’en analyser ensemble les différentes dimensions (économique, sociale, politique, familiale, biographique…) ; elles permettent également d’analyser les caractéristiques des réseaux personnels observés dans le corpus et d’examiner les liens qu’elles entretiennent avec les parcours de vie, ce qui est à notre connaissance sans équivalent. De ce point de vue, elles peuvent donc désormais être mobilisées par un grand nombre de chercheur·ses de différentes disciplines (sociologie, science politique, géographie, sciences de gestion…) dans la perspective de nouvelles publications scientifiques.
Sur le plan méthodologique et pédagogique, l’ouverture des données de l’enquête Vico constitue également de notre point de vue une opportunité forte pour de nombreux réusages. La documentation de l’enquête, ses différents matériaux (questionnaires, grilles d’entretiens…) et les publications méthodologiques qui l’accompagnent peuvent constituer des bases solides pour des réplications de dispositifs d’investigation sur les réseaux personnels et les parcours de vie. Et trois des grandes spécificités de l’enquête – son caractère longitudinal, le recours à des générateurs de noms, et la possibilité d’apparier les réponses aux questionnaires et les transcriptions d’entretiens réalisés avec les mêmes répondant·es – en font un corpus de données là encore sans équivalent pour des usages pédagogiques aussi bien dans le cadre des initiations (dans les licences et les masters de sciences sociales) que des formations pratiques plus avancées (dans le cadre d’écoles thématiques et d’actions nationales de formation) aux méthodes mixtes et à celles de la sociologie des réseaux.
Références bibliographiques
Bessin, M., & Grossetti, M. (2021). Les expériences temporelles du confinement : une épreuve inédite de synchronisation. Temporalités. Revue de sciences sociales et humaines, 34–35. https://doi.org/10.4000/temporalites.10010
Bidart, C., Bozouls, L., Joubert, L., Klüger, E., Pérez, P., & Tucci, I. (2024). Imbriquer les méthodes pour comprendre la dégradation des relations interpersonnelles en temps de crise. Revue française de sociologie, 65(1–2), 91–128. https://doi.org/10.3917/rfs.651.0091
Bidart, C., Castra, M., Chauvel, S., Girard, V., Giraud, C., & Ollivier, C. (2023). Crise de la Covid-19 et confinement : regards sociologiques. Sociologie, 14(2), 149–155. https://doi.org/10.3917/socio.142.0149
Bidart, C., Machut, A., Mercklé, P., & Perdoncin, A. (2024). Quelles données pour analyser les conséquences sociales de la crise sanitaire de la Covid-19 ? L’expérience de PanelVico. Dans V. di Paola & C. Guitton (Dirs.), Crises et transitions : quelles données pour quelles analyses ? XXIXes journées du longitudinal, 24–25 juin 2024, Aix-en-Provence (pp. 305–316). Céreq. https://doi.org/10.4000/11utp
Boulakia, T., & Mariot, N. (2023). L’Attestation. Une expérience d’obéissance de masse, printemps 2020. Anamosa.
Brunel, V., Danciu, A., & Lamrini, N. (2023). Mettre à disposition des données quanti dans le respect du cadre juridique relatif à la vie privée. Pratiques d’anonymisation en SHS. Statistique et société, 11(3). https://doi.org/10.4000/statsoc.1272
Cardon, V., Machut, A., & Perdoncin, A. (2023). L’expérience du confinement des travailleurs sur site à l’intersection du travail et du hors-travail : genre, conditions de travail et relations sociales. Sociologie, 14(2), 175–197.
Cayouette-Remblière, J., Duwez, E., Goffette, C., & Mercklé, P. (2021). Représenter et catégoriser l’espace social. Dans E. Duwez & P. Mercklé (Dirs.), Un panel français : l’Étude longitudinale par Internet pour les sciences sociales (Elipss) (pp. 47–74). Ined Éditions. https://doi.org/10.4000/books.ined.16340
Charlap, C. (2021). Le « temps des femmes » pendant le confinement (mars-mai 2020). Temporalités. Revue de sciences sociales et humaines, 34–35. https://doi.org/10.4000/temporalites.9146
Dufour, Q. (2024). Producing survey data during the pandemic: A history of the Sapris and Epicov projects. Sciences sociales et santé, 42(3), 41–68. https://doi.org/10.1684/sss.2024.0282
Figeac, J., Béliard, A.-S., Bideau, L., & Rives, L. (2024). Quand le pluralisme de l’information des réseaux numériques devient toxique : les tactiques de sous-exposition médiatique et de repli relationnel. RESET. Recherches en sciences sociales sur Internet, 13. https://doi.org/10.4000/11oxc
Figeac, J., Favre, G., Bideau, L., Rives, L., Béliard, A.-S., & Joubert, L. (2022). Les effets secondaires de la crise sanitaire sur les sociabilités médiatisées des Français. Réseaux, 234(4), 165–194. https://doi.org/10.3917/res.234.0165
Grossetti, M., Favre, G., Figeac, J., & Launay, L. (2023). Les perturbations des relations interpersonnelles durant la pandémie de Covid-19. Sociologie, 14(2), 199–221. https://doi.org/10.3917/socio.142.0199
Grossetti, M., & Launay, L. (2021). Turbulences résidentielles et parcours de vie. Saisir les perturbations biographiques à partir des configurations du foyer. Temporalités. Revue de sciences sociales et humaines, 34–35. https://doi.org/10.4000/temporalites.9518
Joubert, L., Van Truoc, O. L., Mercklé, P., & Tudoux, B. (2023). Redresser l’échantillon d’une enquête en ligneâ¯: un exemple à partir de l’enquête Vico. Bulletin of Sociological Methodology/Bulletin de Méthodologie Sociologique, 158(1), 143-166. https://doi.org/10.1177/07591063231160287
Mariot, N., Mercklé, P., & Perdoncin, A. (Dirs.). (2021). Personne ne bouge. Une enquête sur le confinement du printemps 2020. UGA Éditions. https://doi.org/10.4000/books.ugaeditions.18372
Neiter, B., & Buisson, B. (2010). Comment redresser une enquête thématique ? (Document de travail E2010/01). Insee. https://genes.bibli.fr/doc_num.php?explnum_id=10244
Paye, S. (2021). Le sentiment de manquer de temps à l’épreuve du confinement. Temporalités. Revue de sciences sociales et humaines, 34–35. https://doi.org/10.4000/temporalites.9319
Peretti-Watel, P. (Dir.). (2022). Huis-clos avec un virus : comment les Français ont-ils vécu le premier confinement ? Presses universitaires du Septentrion. https://doi.org/10.4000/books.septentrion.127337
Thizy, L., & Mercklé, P. Ouvrir les données en sciences sociales, à quel prix ? Éléments de réflexion à partir d’une enquête longitudinale collective en méthodes mixtes. Sociologie. À paraître.
Notes
1 Le financement « Flash COVID-19 » de l’ANR a notamment financé le projet Coco (« Faire face au Covid-19 : Distanciation sociale, cohésion, et inégalité dans la France de 2020 », CDSP et OSC) ; l’enquête Coconel (Coronavirus et Confinement) (Peretti-Watel, 2022) ; le projet Sapris (« Santé, pratiques, relations et inégalités sociales en population générale pendant la crise Covid-19 »), qui a ensuite donné lieu à la cohorte EpiCov (Epidémiologie et Conditions de vie sous le Covid-19), coordonnée par l’Inserm et la DREES (Dufour, 2024) ; le projet Ciesco « La confiance dans les institutions étatiques et scientifiques à l’épreuve du coronavirus (Gelly, 2023). Au sein du dispositif ELIPSS, l’enquête MaMa (Monde d’Avant, Monde d’Après) réplique des questions posées à un panel représentatif de la population française avant et après la crise sanitaire. Au CEVIPOF, le projet « Citizens' Attitudes Under COVID-19 Pandemic » (CAUCP) étudie l'opinion publique pendant la pandémie de Covid19 dans 11 démocraties entre mars et décembre 2020.
2 Pacte ‐ Laboratoire de sciences sociales (UMR CNRS 5194), du Laboratoire d’économie et de sociologie du travail (LEST, UMR CNRS 7317), du Laboratoire interdisciplinaire solidarités, sociétés, territoires (LISST, UMR CNRS 5193), du Programme Investissement d’Avenir, Initiative d’Excellence d’Aix‐Marseille Université – AMIDEX Sociétés en Mutation en Méditerranée (SoMuM), de l’Université Grenoble Alpes, du Labex Structurations des mondes sociaux (SMS), du Réseau national des maisons des sciences de l’homme (RnMSH), de la TGIR Progédo et des plateformes universitaires de données (PUD) d’Aix‐en‐Provence, Grenoble et Toulouse. Toutes les informations et les actualités du programme sont accessibles sur le carnet Hypothèses du projet de recherche : https://vico.hypotheses.org/.
3 Voir notamment l’ouvrage collectif Personne ne bouge (Mariot, Mercklé et Perdoncin, 2021) ; le livre de Théo Boulakia et Nicolas Mariot, L’Attestation (2023) ; le numéro thématique de la revue Temporalités (2021), « Temps confinés. Parcours de vie, relations sociales et temporalités quotidiennes face à la crise sanitaire et sociale de la revue » (Bessin et Grossetti, 2021 ; Charlap, 2021 ; Grossetti et Launay, 2021 ; Paye, 2021) ; le numéro thématique de la revue Sociologie, « Crise de la covid-19 et confinement : regards sociologiques » (Bidart et al., 2023 ; Cardon, Machut et Perdoncin, 2023 ; Grossetti et al., 2023) ; les articles consacrés aux usages des technologies de communication Figeac et al., 2022, au rapport à l’information médiatique (Figeac et al., 2024), ainsi que des articles consacrés aux méthodes mixtes (Bidart, Bozouls, et al., 2024) ou au redressement des enquêtes en ligne (Joubert et al., 2023).
4 La préparation du corpus et la gestion des données ont impliqué un grand nombre de participant·es. Nous remercions l’ensemble des chercheur·ses du projet ANR ayant contribué à la production des données déposées. La liste intégrale est accessible à cette adresse : https://vico.hypotheses.org/lequipe. Nous remercions l’ensemble de nos stagiaires pour leur contribution à la pseudonymisation des entretiens et des questions ouvertes des questionnaires : Margaux Aupoil, Lucas Borquez, Mathilde Chavatte, Cassandre Lallemand, Munia Merzouk, Jeanne Rozet, Thibault Tronche ; les personnels d’appui à la recherche associés au projet ANR : Sandrine Astor, Max Béligné, Anne Bonneville, Borbala Goncz, Wilda Jean-Baptiste ; les collègues du CDSP auprès de qui le dépôt a été réalisé : Alina Danciu, Guillaume Garcia.
5 Le logiciel était installé sur un serveur de l’Institut des sciences sociales du politique (ISP, CNRS, Université Paris Nanterre) pour les trois premières vagues, puis de l’Institut de recherche en informatique de Toulouse (IRIT, CNRS, Toulouse INP, Universités de Toulouse) pour les vagues suivantes.
6 Un kit pédagogique issu des données quantitatives de la Vague 1 est également disponible sur notre blog de recherche, à cette adresse : https://vico.hypotheses.org/donnees.
7 Les données sources ne se composaient pas d’un talon socio-démographique systématique mais d’une actualisation de la situation déclarée en Vague 1. Pour faciliter les utilisations transversales des données, nous avons reconstruit ces variables, en conservant la situation déclarée en Vague 1 en l’absence de changement, en l’actualisant sinon.
8 Il s’agit de variables susceptibles de lever l’anonymat des répondant·es, parce qu’elles contiennent des informations nominatives ou parce que leur degré de précision et leur combinaison avec d’autres informations publiquement disponibles peut être unique dans l’ensemble de la population.
9 Ce choix de procéder par suppression (plutôt que par substitution ou hyperonymie comme pour les entretiens) s’explique par les contraintes méthodologiques d’un tel procédé, qui supposait de pouvoir intervenir qualitativement dans des données quantitatives exploitées avec RStudio. Pour cela, nous avons extrait l’intégralité des questions ouvertes de chaque vague dans un classeur Excel (une feuille par question). La première colonne regroupait les identifiants des panélistes, la deuxième leur réponse à la question ouverte. Dans la troisième, nous avons signalé à la main tous les éléments qui devaient être retirés. Le classeur a ensuite été réimporté dans R pour réintroduire les questions anonymisées dans les données des questionnaires : un script dédié remplaçait les données identifiantes de la troisième colonne par [...] dans la deuxième colonne.
10 Par exemple (fictif), nous n’avons pas touché à une mention du type : « Je fais partie d’une association qui aide les migrants ». Mais nous avons pu raccourcir des énoncés du type : « Je fais partie d’une association qui aide les migrants, je fais également partie d’une troupe de théâtre itinérante et j’assure la trésorerie du comité des fêtes de mon village » de la façon suivante : « Je fais partie d’une association qui aide les […], je fais également partie d’une […] et j’assure la trésorerie du […] de mon village ».
11 https://coulmont.com/bac/.
12 À ce jour, la vague 5, qui porte sur l’évolution des relations personnelles et les pratiques culturelles, a été administrée au panel rafraîchi (ancien·nes et nouveaux·elles panélistes) entre le lundi 3 février 2025 et le jeudi 3 avril 2025, pour un total de 4 681 réponses complètes ; et la vague 6, qui porte sur le rapport au travail depuis la pandémie, a été administrée entre le vendredi 23 janvier 2026 et le jeudi 2 avril 2026, pour un total de 3 875 réponses complètes.
13 Le réseau national des PUD est porté par Progedo (CNRS-EHESS) et hébergé dans la plupart des cas au sein des Maisons des Sciences humaines (MSH). Sa mission est de favoriser l’accès aux données quantitatives issues de la statistique publique (enquêtes, données administratives, données de recherche) et de faciliter leur réutilisation pour les chercheur·ses, doctorant·es et étudiant·es en sciences humaines et sociales.
 Contacter l'auteur
 Lire la suite